
Deux erreurs sur cinq : ce que l'IA produit sur le CAC 40
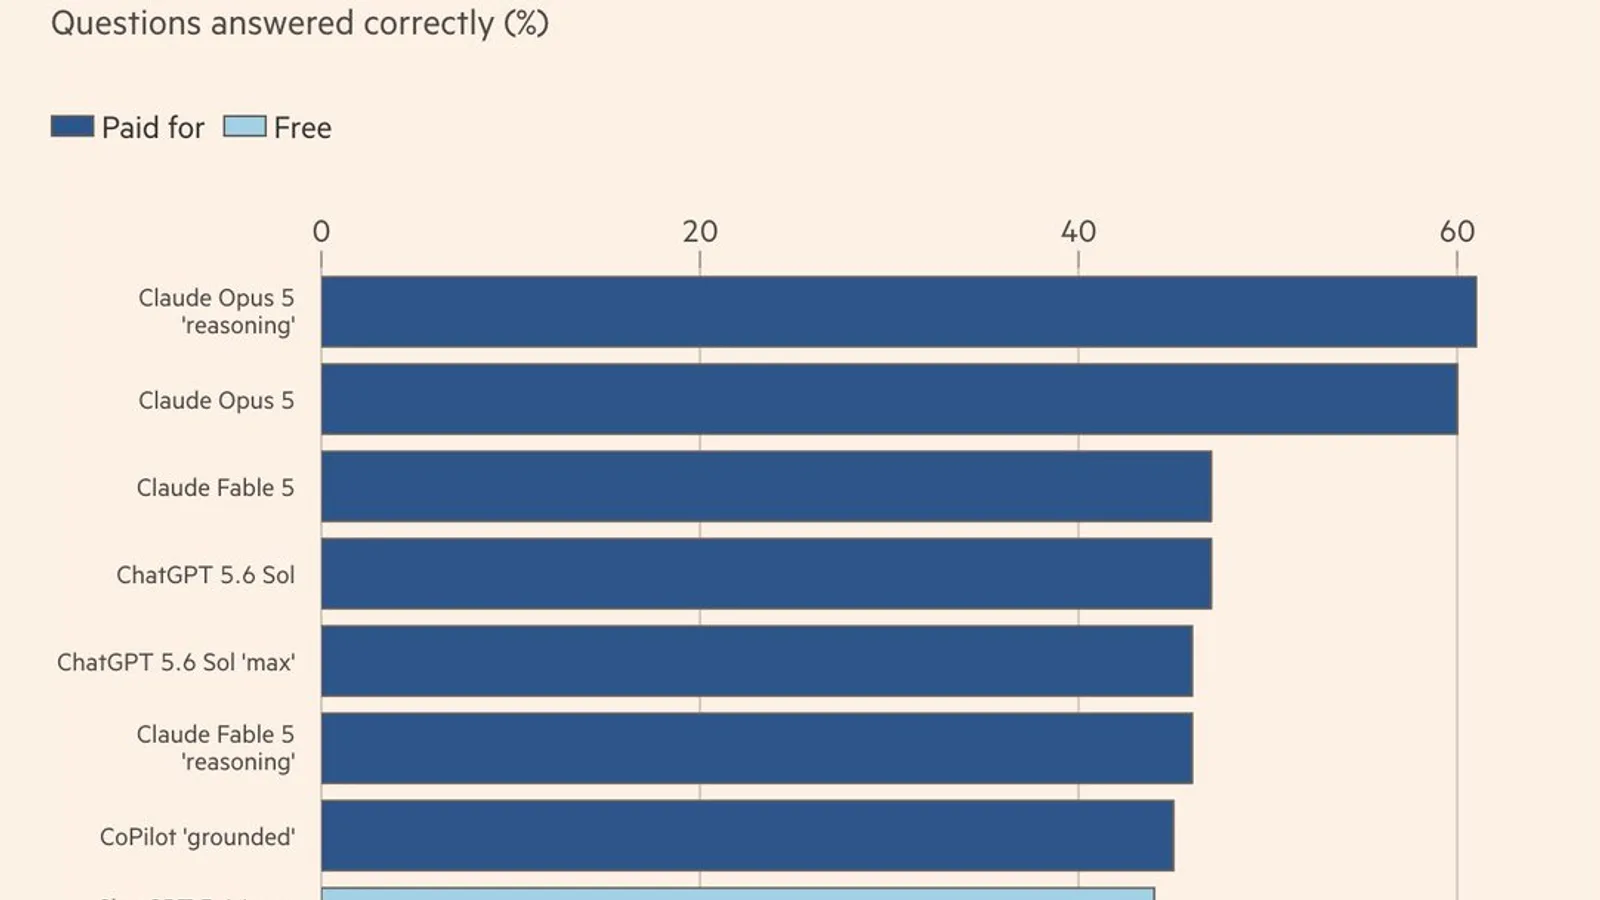
L'étude est signée des cabinets Reputation Age et Bubbling, menée cet automne sur les derniers comptes semestriels des entreprises de l'indice. Résultat : 40% des données financières générées par l'IA sont incorrectes. Chiffres confondus entre sociétés, données périmées, informations inventées de toutes pièces : le panel d'erreurs est large. Pour Emmanuel Dollé, cofondateur de Bubbling, la cause peut être une question mal formulée par l'utilisateur, mais aussi une donnée trop pointue pour que l'outil la restitue fidèlement.
Ce taux d'erreur n'est pas anodin. L'IA ne produit pas un résultat aléatoire : elle formule une réponse assurée, sans signaler systématiquement ses lacunes. Un investisseur non averti n'a aucun moyen de distinguer un chiffre exact d'un chiffre fabriqué si la réponse est présentée avec la même fluidité. Autrement dit, la forme de la réponse ne trahit pas son contenu : un chiffre inventé arrive avec le même aplomb qu'un chiffre vérifié, dans la même syntaxe, avec la même apparence de précision.
Ce que l'étude met en lumière, c'est aussi la diversité des types d'erreurs. Confondre deux sociétés du même indice, recycler un résultat semestriel qui ne correspond plus à la période demandée, ou produire un chiffre qui n'a jamais existé dans aucun document : ces trois catégories d'erreurs n'ont pas la même origine, mais elles ont le même effet pour celui qui les reçoit sans les questionner. Dans les trois cas, la décision qui suit repose sur une base fausse.
Des millions de Français déjà exposés
Le problème ne serait qu'académique si l'usage restait marginal. Ce n'est pas le cas. Selon un sondage de l'Autorité des marchés financiers publié l'an dernier, 11% des Français déclarent utiliser l'IA pour s'informer avant un placement. Plus significatif encore : 37% l'emploient pour identifier eux-mêmes le placement qui leur convient. En clair, l'outil n'est plus seulement un moteur de recherche amélioré : il joue un rôle actif dans la décision d'investissement.
Rapporté à la population adulte, un Français sur 9 s'appuie donc sur un système qui se trompe deux fois sur cinq sur les données du principal indice boursier français. Ce ratio mérite d'être lu dans les deux sens. D'un côté, la proportion d'utilisateurs qui font confiance à l'IA pour orienter leurs placements est déjà substantielle. De l'autre, le taux d'erreur documenté sur le CAC 40 est suffisamment élevé pour que cette confiance soit, dans un nombre significatif de cas, mal placée.
La question de la formulation joue un rôle, comme le souligne Emmanuel Dollé. Une question imprécise peut conduire l'outil vers une réponse approximative. Mais le problème ne se réduit pas à la qualité de la requête : certaines données sont simplement trop granulaires, trop récentes ou trop spécifiques pour que les outils disponibles les restituent avec fiabilité. L'utilisateur, lui, ne sait généralement pas dans quel cas il se trouve.
L'AMF n'a pas encore formulé de cadre spécifique à l'usage de l'IA dans le conseil financier non professionnel, mais la question monte dans les agendas réglementaires européens.
Pourquoi c'est important pour vos actifs
- $CAC▼ Baissier
Sens qualitatif, sans prévision de prix. Source : nos modèles de corrélation historique.
Une diffusion massive de données erronées peut fausser les anticipations de nombreux investisseurs particuliers sur des titres précis. Selon nos modèles de corrélation historique, ce risque informationnel pèse davantage sur les valeurs individuelles que sur l'indice dans son ensemble : ce sont les titres directement cités dans une réponse incorrecte qui concentrent l'exposition et non le CAC 40 dans sa globalité. L'indice agrège suffisamment de composantes pour amortir les effets d'une erreur localisée, mais une valeur prise isolément, mal décrite dans une réponse IA, peut voir ses anticipations de marché faussées par un flux d'investisseurs particuliers agissant sur la même information défectueuse.
La lecture de marché associée à cette dynamique est baissière pour les titres concernés : non pas parce que leurs fondamentaux se dégradent, mais parce que les décisions prises sur la base de données erronées introduisent un bruit supplémentaire dans la formation des prix.